# 基地定位:让大模型“有题可刷、刷得规范”
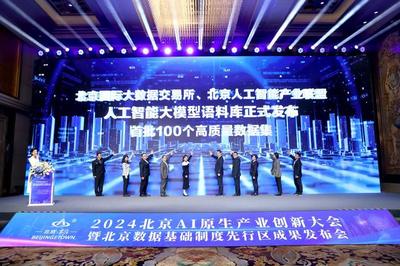
一场聚焦人工智能数据训练基础设施的活动近日在北京亦庄举行,国内首个面向人工智能数据训练的公共基地正式启用。该基地由北京国际大数据交易所与北京经济技术开发区联合推动建设,旨在为大模型企业提供高质量、合规、规模化的数据训练环境。
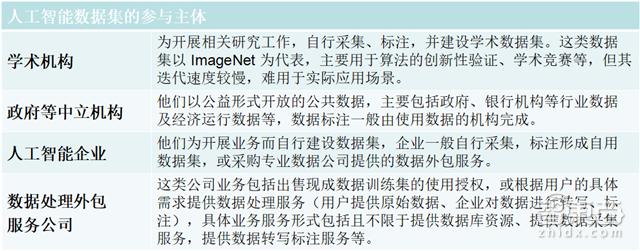
大模型的性能提升高度依赖训练数据的质量与规模。然而,企业获取合规数据面临成本高、渠道分散、版权风险等多重障碍。该基地的核心功能是整合公共数据资源,建立标准化的数据加工、清洗、标注与交付流程,为大模型训练提供“一站式数据后厨”。
据介绍,基地首批开放的数据涵盖政务公开数据、行业知识库、科研文献摘要等多个类别,均经过脱敏与合规审查。训练基地还将建立数据使用追溯机制,确保每一批数据来源可查、去向可追。
“刷题”的背后:数据规模与质量的双重博弈
业内常将大模型训练比作“刷题”——模型在海量数据中反复学习,以提升泛化能力。但与人类刷题不同,大模型的数据训练更强调多样性、准确性与领域覆盖度。首个人工智能数据训练基地的启用,意味着数据供给正从企业“各自找米”转向公共平台“统一供粮”。
这一模式的价值在于:一方面降低中小企业获取高质量数据的门槛;另一方面通过公共平台统筹,减少重复采集与数据浪费。
SEO视角下的关键信息
从搜索意图来看,围绕“人工智能数据训练基地”“人工智能公共数据”“大模型数据训练”等关键词,用户核心关注点为:基地在哪、由谁建设、提供什么数据、企业如何接入、有何合规保障。
已启用的基地主要信息如下:
- 所在地:北京经济技术开发区(亦庄)
- 推动方:北京国际大数据交易所、北京经济技术开发区
- 核心服务:公共数据整合、数据清洗标注、合规审查、数据交付与追溯
- 目标对象:大模型研发企业、AI训练机构、科研单位
##
随着首个公共数据训练基地的落地,大模型“刷题”将逐步走向规范化、集约化。下一步,基地能否在数据供给效率与合规安全之间取得平衡,将决定其能否真正成为AI产业的“数据基座”。对于AI企业而言,尽早了解并接入此类公共数据通道,或成为降低训练成本、提速模型迭代的可行路径。
如若转载,请注明出处:http://www.dingcanbokeji.com/product/41.html
更新时间:2026-11-01 00:15:57