计算力就是生产力 中国AI算力有多强?
在数字经济时代,计算力已成为继热力、电力之后新的关键生产力。从天气预报到基因测序,从智能推荐到自动驾驶,算力的大小直接决定了一个国家在人工智能赛道上的奔跑速度。中国AI算力到底有多强?答案需要从基础设施规模、芯片自主程度、公共数据体系与企业参与度等多个维度来审视。
一、算力规模:位居全球第一梯队
据工业和信息化部数据,截至2023年底,中国在用数据中心标准机架总规模超过810万架,算力总规模达到230 EFLOPS(每秒浮点运算次数),位居全球第二,仅次于美国。其中,智能算力(专为AI训练和推理设计的算力)规模达到70 EFLOPS,同比增长超过60%,增速领跑全球。在中国算力结构中,智能算力的占比已提升至30%以上,反映出AI需求的迅猛增长。
从区域布局看,京津冀、长三角、粤港澳大湾区、成渝等国家算力枢纽节点建设加速。八大国家算力枢纽节点与十大数据中心集群构成了“东数西算”的骨干网络,使西部清洁能源与东部计算需求高效匹配,进一步降低了边际算力成本。
二、芯片自主:有突破,短板依然存在
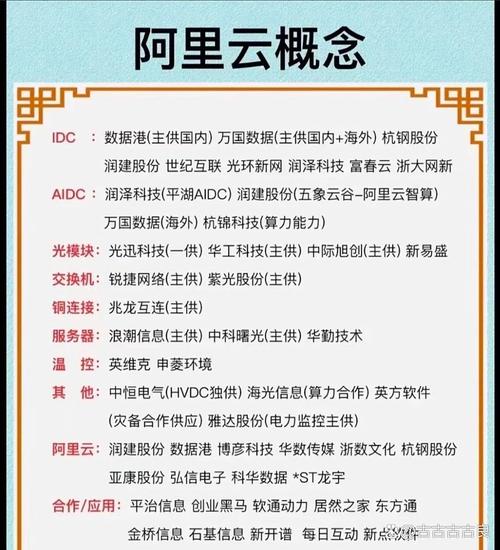
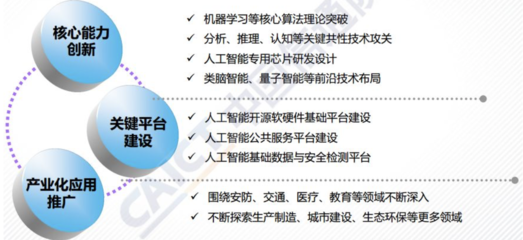
算力强不强,关键看AI芯片。当前国产AI芯片的代表企业如华为昇腾、寒武纪、海光信息等已在训练和推理场景中大规模落地。以华为昇腾910B为例,其单卡半精度浮点算力可达320 TFLOPS,总体处于国际同类产品的先进梯队。阿里平头哥、百度昆仑芯等也在持续推进。
但必须承认,在高端制程工艺、存储带宽、软件生态方面,中国与国际顶尖水平仍有差距。美国出口管制使得获取英伟达最先进GPU受阻,反过来也刺激了国产替代的提速。目前全国已有数十个智算中心宣布采用国产AI芯片比例超过50%,部分新建项目国产化率高达70%—80%。能不能稳定、高效地供给算力,成为电力之外的另一场基础设施竞赛。
三、人工智能公共数据:规模和开放亟待破局
AI算法的“燃料”是数据。尤其在大模型时代,高质量中文语料、标注数据集、行业公共数据,在很大程度上决定模型能力的上限。中国在公共数据领域拥有独特优势:人口多、场景广、政府数据资源庞大。
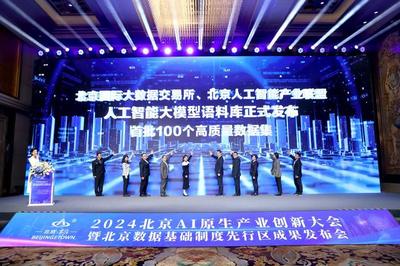
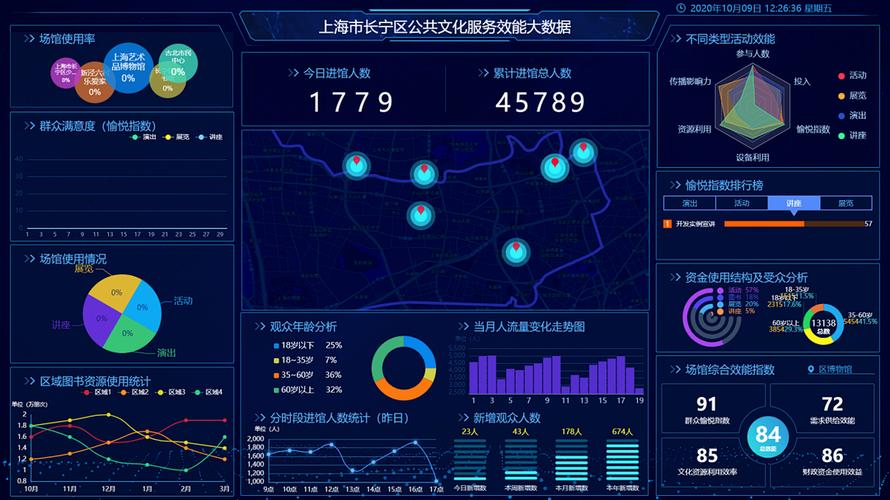
目前,全国已建立多个公共数据开放平台,例如北京、上海、贵州、浙江等地建立了公共数据开放平台,开放的政务、交通、气象、医疗等领域数据集总量超过百万级。然而面临的核心问题有三个:确权难、定价难、安全问题致共享难。高校和初创企业很难获得头部平台所掌控的大规模独立数据;行业内的数据也常常孤立分布。
好消息是政策正在联动。2023年国家数据局成立,统筹数据资源整合共享与开发利用,随后“数据要素×”三年行动计划(2024—2026年)将工业制造、医疗健康、交通运输作为一个底层突破口。部分省市同步启动了公共数据授权运营的试点,合规的公共数据经授权后可以加工形成数据产品服务于AI研发。可信数据空间、联邦学习、隐私计算正在逐步铺开,但与充足供给相差距离仍明显。
四、算力有多强,不只取决于绝对值
衡量中国AI算力究竟有多强,并非一项单一排名能说清。总规模层面,谁高谁低似乎一看清二;但高效使用、普惠成本、稳定与绿色几个因素结合来看更值重视。
而且各类评估下的实质更清楚:高效的开放公共数据的操作。谁能先把分散的数据和安全技术的机制串起来,让公共数据流入模型创作并驱动实体经济走向产出层的数据基础建设成型,落出实践的效果就有成型。仅据乐观的计算:某种高性能算法推出某一高阶参数模型持续获取公开检测准确率榜上体现出它能在公共数据强支撑加持自身优化的优良能力反应训练中可行规模化得到实现算力的存在量大大得深化到像使用算力作为水龙头打开那般应用态势——就不再是一句纯计算对比产物表现出的强弱解读无果不明何为了。
终:随着各地智算中心如力量投入资本比重较快、被AI催动生成的算料,被数据支撑的现象等逐步表现旺盛趋势,相应的动能通过硬件使用量和新的智能体现下的经济增益正在告诉太多——全世界布局中的节点和活跃情形正是数字时代经济由重要组成部分,AI也许持续构成助力确定显著表现。
如若转载,请注明出处:http://www.dingcanbokeji.com/product/15.html
更新时间:2026-11-01 22:44:07